Any Time · Any Space

给长剧本一套能“记住世界”的视频生成框架 A World-State-Centric Framework for Agentic Video Generation

现有文生视频在单镜头里已经很能打,但一到多镜头、换机位、切场景再回到同一个房间,空间布局和人物动作就容易崩。ATAS 的做法不是把提示词传给下一个镜头,而是维护一个可持久化的“世界状态”:同一个地方在同一个坐标系里,同一个事件带时间索引,所以可以随时回去、随时换个机位重拍。

浙大 ZIP Lab · 莫纳什 · UC Berkeley BAIR · 阿德莱德
arXiv 2610.20571
2026-10-14 预印本
代码 MIT 开源

现在就喂一段剧本给分镜智能体 →

它要解决的三件事

长片不是把 30 个 5 秒镜头拼起来。真正难的是“非连续请求”——第 12 个镜头要回到第 3 个镜头的房间,第 20 个镜头要把第 8 个镜头的事件换个视角重演一次。

PROBLEM 01

没有共同的坐标系

只靠提示词或近几帧画面,模型不知道“同一个房间”到底在哪,回访时布局只能靠猜。

PROBLEM 02

没有按时间索引的记录

事件发生过什么、在第几秒、谁在什么位置,没有结构化存储,重演就只能重新编。

PROBLEM 03

错误会顺着记忆扩散

一帧崩坏的生成结果被当成“已知事实”传给下一镜头,后面越拍越歪。

四步闭环:编译 → 检索 → 生成 → 校验入库

ATAS 把剧本当成输入,把“镜头请求”当成中间产物,把世界状态当成长期记忆。

STEP 01剧本编译递归拆解剧本,产出带场景号、空间锚点、机位、时间区间、事件号的镜头请求。
STEP 02双记忆检索场景记忆给出静态几何,按请求机位重渲一张参考图;事件记忆按场景/事件/时间取出动态证据。
STEP 03条件生成把镜头描述与检索到的上下文一起喂给视频生成器,插件式,可换后端。
STEP 04校验入库成片先做重建与配准;只有“成片通过 + 配准成功 + 状态检查”三项同时成立,才允许写回世界状态。
MEMORY A

场景记忆 Scene Memory

保存已接纳的静态几何,统一在一个源观测建立的坐标系里;要回访就按目标机位渲染参考视图。

MEMORY B

事件记忆 Event Memory

保存带时间索引的动态观测:帧级 RGB-D、掩码、动态点云,按“场景 / 事件 / 时间”三元检索。

SAFETY

交付与记忆解耦

成片能不能用,和这条观测能不能进记忆,是两个独立判定。坏镜头可以留在片子里,但不许污染世界状态。
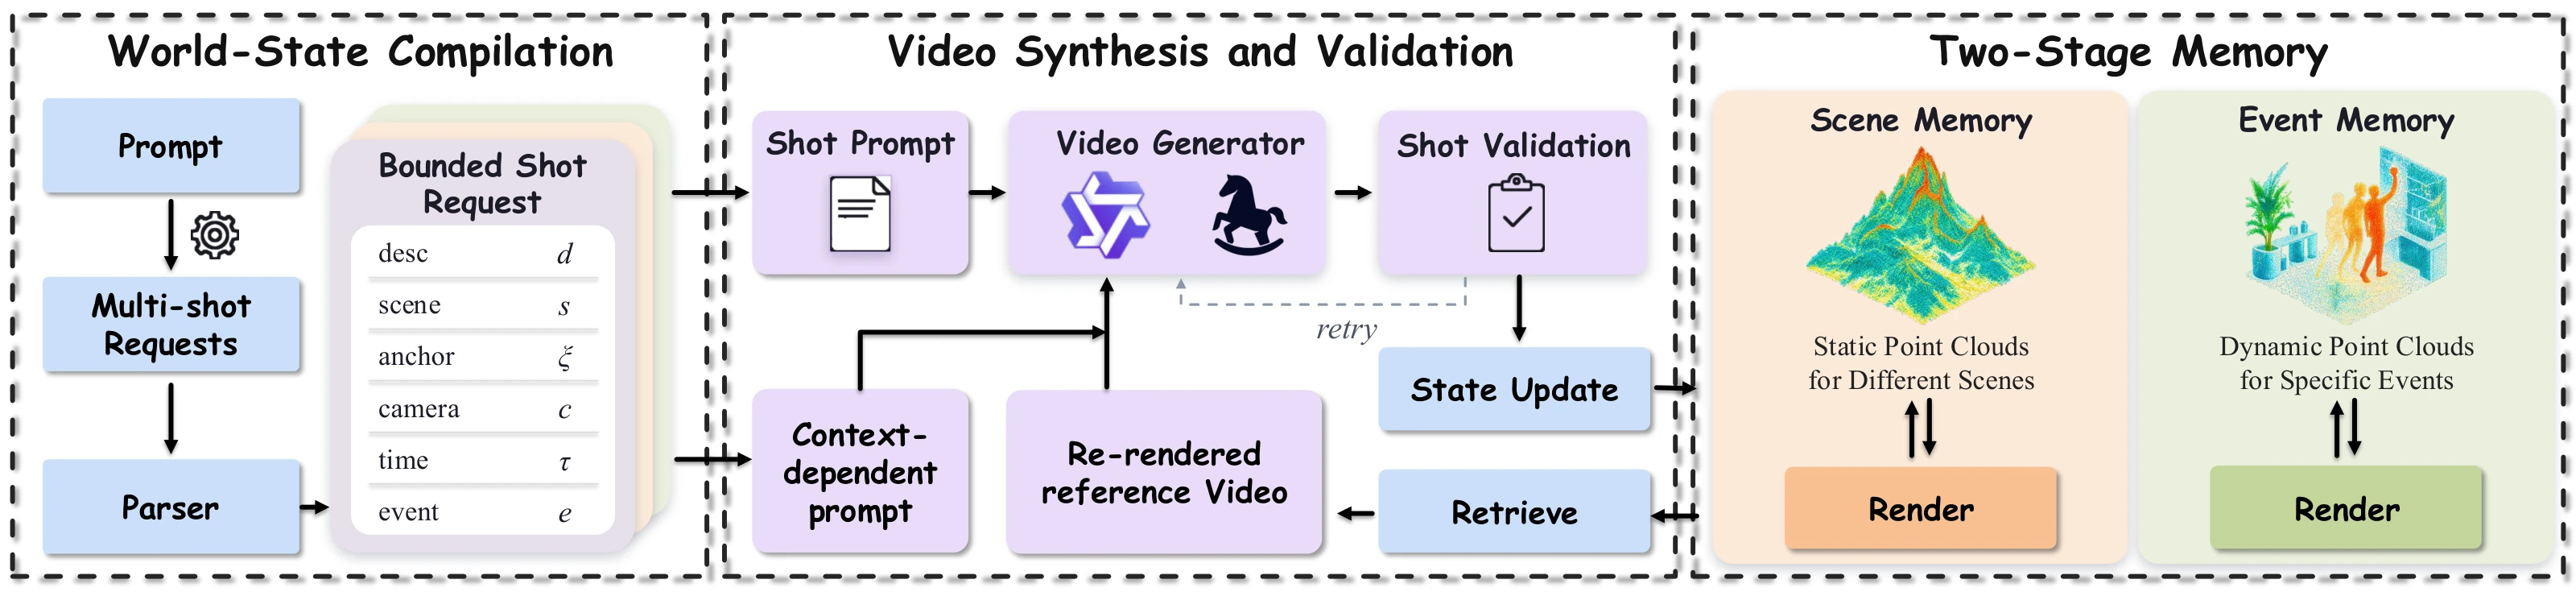
ATAS 工作流:剧本编译、双记忆检索、生成、重建配准与校验入库
论文图 2 · ATAS 工作流:剧本 → 镜头请求 → 记忆检索 → 生成 → 重建配准 → 校验入库
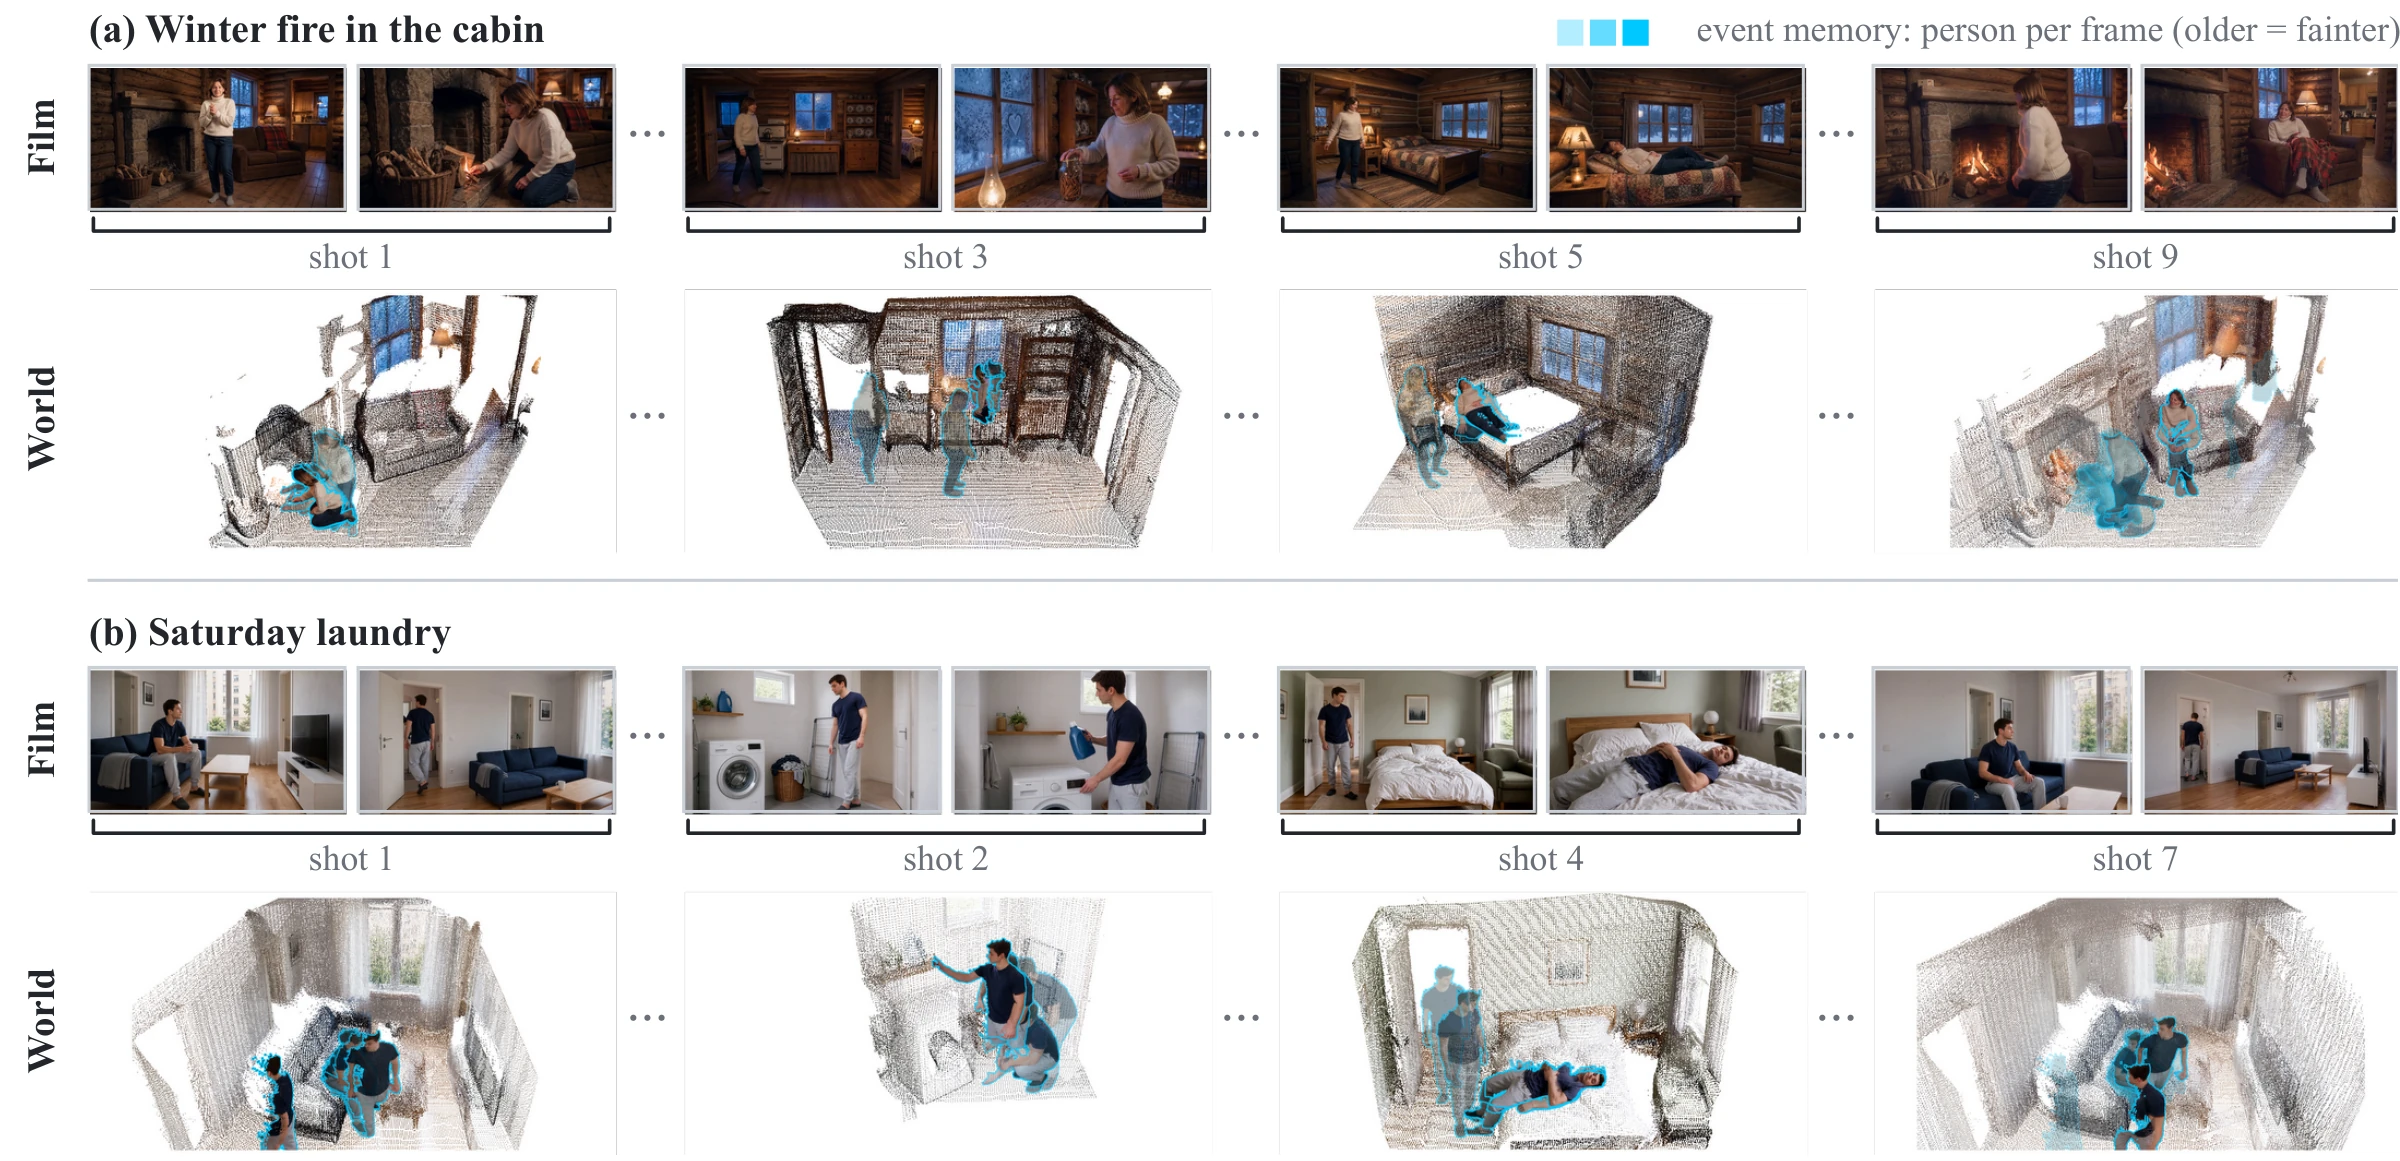
ATAS 在一个故事推进过程中的影片与世界状态演化
论文图 3 · 随着故事推进,影片在拍,世界状态在长

实测说了什么

在 VBench、ST-Bench、ViStory 三套基准上,对四种视频生成后端(MiniMax-H3、Wan 3.0、Wan 2.7、HappyHorse 1.0)分别接上 ATAS。

跨后端

一致性全面提升

论文报告:四种后端下所有跨镜头一致性指标均有提升,每种后端的综合分都是最高。

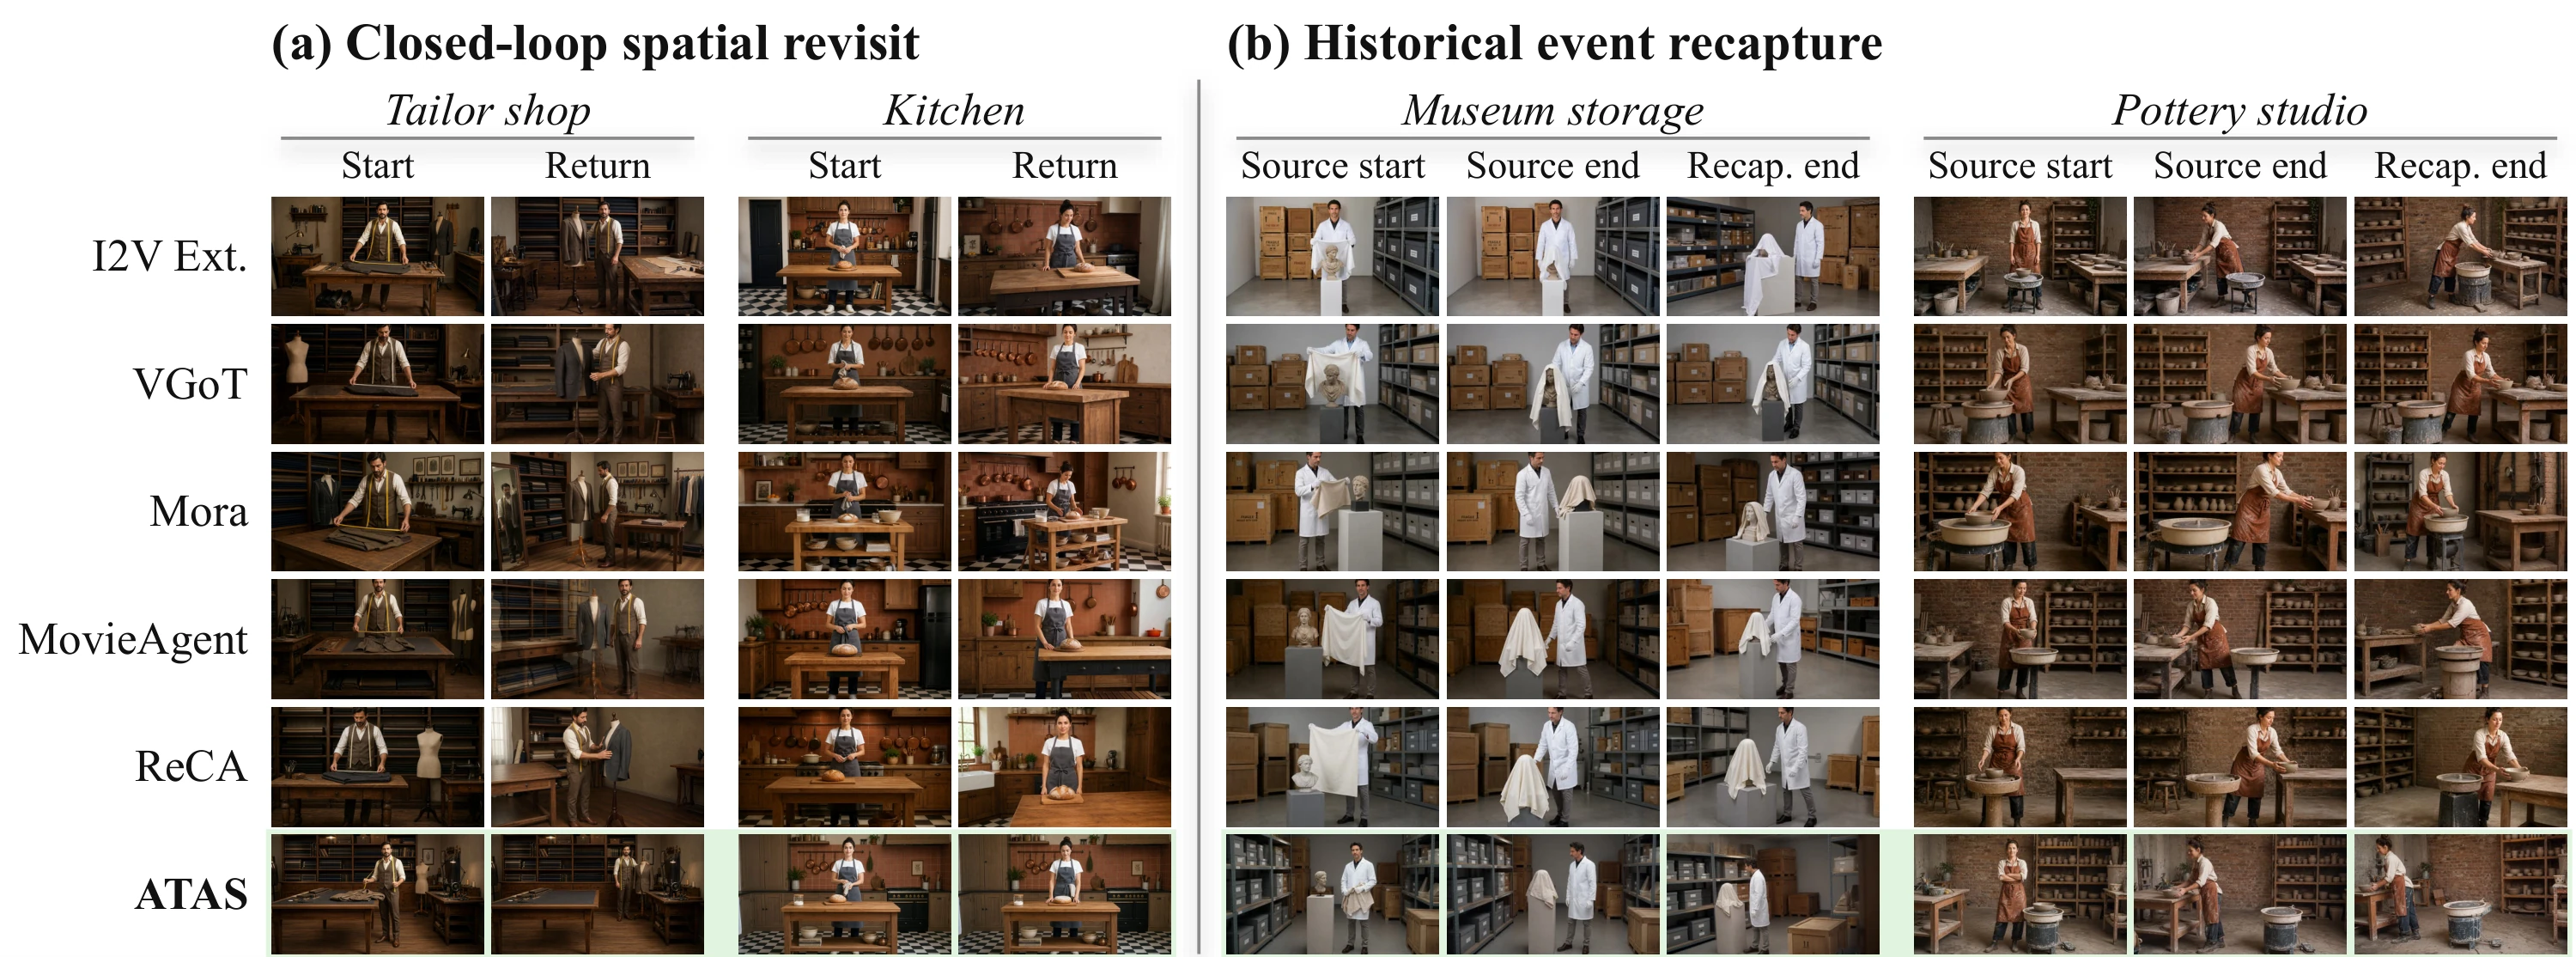
空间回访

PSNR / SSIM 更高,LPIPS 更低

在“回到目标视角”这项上优于多镜头智能体方案与 3D 引导方案(含 ViewCrafter)。

事件重演

事件一致性 / 时序 / 机位实现领先

事件复现五项判据中领先三项,人工评分六项(含剧本遵循度、角色一致性)均为最高。

空间回访与事件重演对比
论文图 4 · 空间回访与事件重演对比
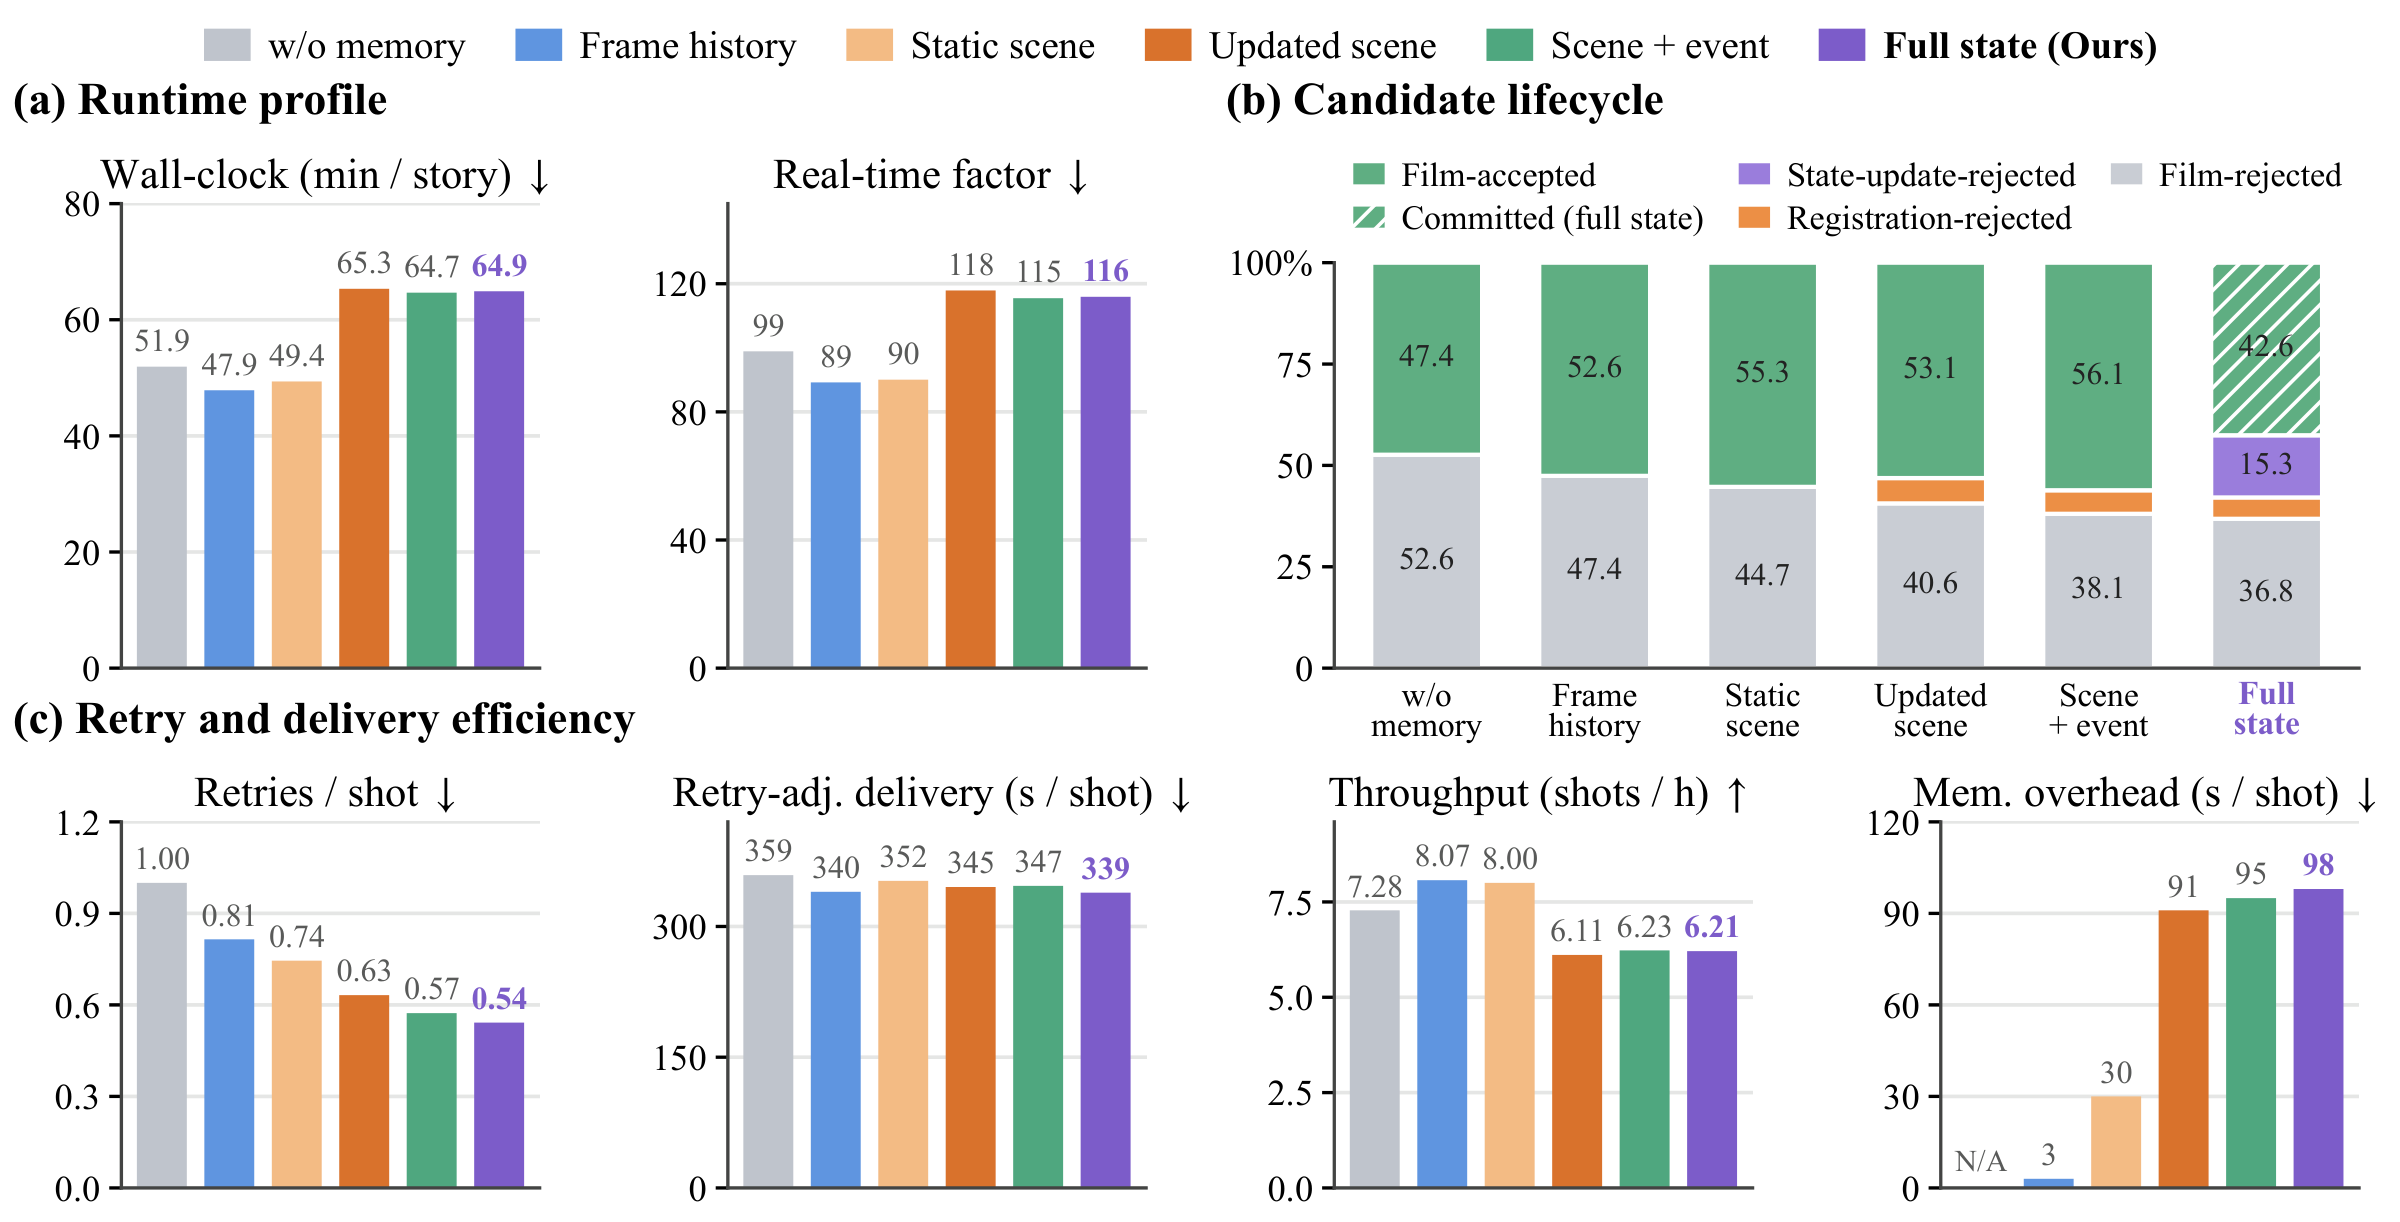
不同记忆配置下的运行时间与候选生命周期
论文图 5 · 运行时间、候选生命周期与交付效率
一句话记住它:不是把上一帧喂给下一帧,而是把“整个世界”留在后台,下一镜头去问它要证据。

怎么跑起来:两块东西,不是一块

ATAS 分客户端与几何服务两部分。客户端可以跑在任何机器上(不需要 GPU);几何服务必须落在有 NVIDIA 显卡的机器上。

组件硬件关键依赖作用
client普通 CPU 机器,Python 3.12,需要 ffmpeg阿里云百炼 DASHSCOPE_API_KEY(Wan 3.0 视频生成)、任意 OpenAI 兼容网关(编译/评审/出图)剧本编译、镜头规划、调用生成、审片、成片合成
geometryNVIDIA GPU,约 20GB 空闲显存(低显存配置峰值)torch + CUDA、Pi3X 重建权重、SAM3 分割权重重建、配准、世界版本管理、按机位渲染记忆视图
# 1) 几何服务(GPU 机器上)
pip install -r geometry/environment.snapshot.txt && pip install -e geometry
cp geometry/.env.example geometry/.env    # 设 GEOMETRY_PYTHON / GEOMETRY_MODEL_ROOT / GEOMETRY_GPU_IDS
cd geometry && ./run_geometry_service.sh    # 健康检查:curl http://127.0.0.1:18300/readyz

# 2) 客户端(任意机器)
pip install -e client
cp client/.env.example client/.env        # 设 DASHSCOPE_API_KEY / ATAS_LLM_* / GEOMETRY_SERVICE_URL

# 3) 一条命令出片
atas run --screenplay examples/bookstore/screenplay.txt \
         --characters examples/bookstore/characters.json --story-id bookstore
成本与算力提示:视频生成走百炼 Wan 3.0 按量计费,长片按镜头数量线性叠加;几何服务常驻占用约 20GB 显存。想先看流程不花钱,可用 --plan-only 只做编译不生成。

本机部署状态(j.aixgn.cn)

这一页是第三方开源项目的镜像展示页。下面是它在这台服务器上的真实落地情况,不做美化。

项目状态说明
源码镜像 /opt/atas/src已完成client + geometry 全量代码、示例剧本、论文图(入口机 39 与本页宿主同机)
client 安装(Python 3.12 venv)已完成装在应用后端机(117),atas --help 正常;LLM/出图/视频三段后端均已接通,可直接 atas run 出片
ffmpeg 运行时已完成由 imageio-ffmpeg 内置二进制软链到 /usr/local/bin/ffmpeg
分镜智能体服务已升级为 Studio/atas/agent/ · 前端 + FastAPI 后端 + SQLite 三层;剧本进库、任务进队列、分镜与产物落表,SSE 推进度;后端 117:18311(systemd atas-studio),仅 WireGuard 内网可达
数据库已接入SQLite(/opt/atas/studio/studio.db,WAL):screenplays / jobs / scenes / shots / artifacts / events / quota 七张表,历史任务已回填
geometry 几何服务不可用现有 4 台服务器(124/39/159/117)均为 2-4 核 3G 内存、无 NVIDIA 显卡,需 ≥20GB 显存的 GPU 机器
百炼视频生成已接通DASHSCOPE_API_KEY 已配置,Wan 视频合成按量计费;实测 1 镜成片 7.9MB / 629 秒
LLM 网关已接通直连百炼兼容模式(qwen3.8-27b),剧本编译与审片走真实模型
出图后端已接通百炼不提供 gpt-image-2,本机用兼容层 atas-image-shim 把 ATAS 的 images 请求翻译成 wanx2.1 文生图,产出角色参考图与首帧
Wan 视频额度受限账号开着"仅用免费额度"模式,免费额度现已用尽;4 镜实测在最后一镜触发 403 AllocationQuota.FreeTierOnly。充值或关闭该模式即可继续

结论:剧本进、成片出,链路已经真实跑通(实测 job ff3173b71d9d 产出 7.9MB final.mp4,公网可下载);多镜长片受百炼免费额度限制,属账户充值问题,不是服务能力问题。仍缺 GPU 几何服务,跨镜头一致性走无记忆模式。

官方资源